페이지네이션이란?
페이지네이션은 목록을 여러 쪽으로 나눕니다
상품 목록이나 글 목록처럼 항목이 많을 때, 한 쪽에 다 싣지 않고 1, 2, 3…으로 나눠 보여 주는 방식입니다. 우리말로는 쪽 나누기나 페이징이라고도 합니다.
구글은 긴 목록을 다루는 방법을 세 가지로 나눠 적습니다. 번호를 눌러 넘기는 페이지네이션, 버튼을 눌러 더 불러오는 더 보기, 끝까지 내리면 계속 이어지는 무한 스크롤입니다.1[1]구글 문서는 이렇게 적습니다. “To display a subset of a larger list, you can choose between different UX patterns: Pagination: Where a user can use links such as “next”, “previous”, and page numbers to navigate between pages that display one page of results at a time. Load more: Buttons that a user can click…” 같은 쪽에서 구글은 셋의 장단점을 표로 비교하는데, 무한 스크롤의 단점으로는 결과가 얼마나 되는지 알 수 없어 생기는 “스크롤 피로”와 아주 많은 결과를 감당하지 못한다는 점을 듭니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역) 셋 다 같은 문제를 안고 있는데, 첫 화면에 없는 항목을 검색엔진이 어떻게 찾느냐입니다.
2페이지 뒤의 글이 발견되지 않습니다
사람은 버튼을 눌러 다음 쪽으로 가지만, 검색엔진은 버튼을 누르지 않습니다. 구글은 링크가 href 속성을 가진 <a> 요소일 때만 그 링크를 발견한다고 적습니다.2[2]구글 자바스크립트 SEO 문서의 문장입니다. “Google can only discover your links if they are <a> HTML elements with an href attribute.” 같은 쪽은 자바스크립트로 링크를 넣는 것 자체는 괜찮다고 덧붙입니다. 문제는 자바스크립트냐 아니냐가 아니라, 최종적으로 href를 가진 <a>가 되느냐입니다.출처[7] Google 검색 센터 - JavaScript SEO basics (크롤링 가능한 링크, 영어 원문) 번호를 자바스크립트 버튼이나 onclick으로 만들어 두면 2페이지가 없는 것과 같습니다.
무한 스크롤은 더 심합니다. 구글은 크롤러가 스크롤이나 버튼 누르기를 흉내 내지 못한다고 적습니다. 그래서 목록의 개별 항목에 늘 닿지는 못합니다.3[3]구글 문서의 문장입니다. “With infinite scroll, crawlers cannot always emulate manual user behavior—like scrolling or clicking a button to load more items—so they don’t always access all individual items in the feed or gallery.” 이 문장은 전자상거래 쪽 문서에 있지만 상품 목록에만 해당하는 이야기가 아닙니다. 글 목록이나 게시판도 구조가 같기 때문입니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
같은 쪽에서 구글은 닿지 못하면 검색 결과에 나올 가능성이 낮다고 이유까지 적었습니다. 페이지네이션이 디자인이 아니라 발견의 문제인 이유가 이것입니다.4[4]구글 문서의 문장입니다. “If crawlers can’t access your content, it’s unlikely to surface in search results.” 이 문장은 전자상거래 쪽 문서에 있지만 상품 목록에만 해당하는 이야기가 아닙니다. 글 목록이나 게시판도 구조가 같기 때문입니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
버려진 rel=next
구글은 2011년에 합쳐 준다고 했습니다
페이지네이션 이야기에는 늘 rel="next"와 rel="prev"가 나옵니다. 2011년 9월에 구글이 내놓은 표시입니다. 당시 구글은 이것을 캐노니컬과 비슷한 강한 힌트라고 소개했습니다.5[5]2011년 9월 15일 구글 블로그의 문장입니다. “Much like rel=“canonical” acts a strong hint for duplicate content, you can now use the HTML link elements rel=“next” and rel=“prev” to indicate the relationship between component URLs in a paginated series.” 캐노니컬에 빗댄 것이 당시로서는 자연스러웠습니다. 둘 다 중복처럼 보이는 주소들을 어떻게 다룰지 알리는 표시였기 때문입니다.출처[2] Google 검색 센터 블로그 - Pagination with rel="next" and rel="prev" (2011-09-15, 폐기 배너 붙음)
약속한 효과가 구체적이었습니다. 쪽쪽이 흩어진 색인 속성을 시리즈 전체로 모아 주고, 검색한 사람을 보통 첫 페이지로 보내 준다는 것이었습니다.6[6]2012년 3월 글이 더 또렷하게 적었습니다. “When you implement rel=“next” and rel=“prev” on component pages of a series, we’ll then consolidate the indexing properties from the component pages and attempt to direct users to the most relevant page/URL. This is typically the first page.” 여기서 눈여겨볼 낱말이 consolidate입니다. 흩어진 것을 한곳으로 모은다는 뜻이고, 당시 구글이 캐노니컬을 설명할 때 쓰던 말과 같습니다. 뒤에 나올 캐노니컬 이야기와 이 태그가 자주 섞이는 이유가 여기에 있습니다.출처[3] Google 검색 센터 블로그 - Video about pagination with rel="next" and rel="prev" (2012-03-13, 폐기 배너 붙음) “이 태그가 여러 페이지를 하나로 합쳐 준다”는 말은 여기서 나왔습니다.
구글은 그 글 위에 폐기 배너를 붙였습니다
2019년 3월 21일, 구글은 봄맞이 정리라며 이 표시를 버린다고 알렸습니다.7[7]당시 구글 웹마스터 계정이 트위터에 올린 글입니다. “Spring cleaning! As we evaluated our indexing signals, we decided to retire rel=prev/next. Studies show that users love single-page content, aim for that when possible, but multi-part is also fine for Google Search.” 계정 이름이 바뀌어 지금 원본을 열 수 없어 저희는 보존본으로 확인했습니다. 글 시각은 2019년 3월 21일입니다. 구글은 이 폐기를 블로그 글이나 문서 공지로는 따로 내지 않았고, 트위터 글 하나가 전부였습니다. 뒤에 나올 “한 줄짜리 배너”가 사실상의 공지 노릇을 하고 있습니다.출처[11] Frédéric Dubut(당시 빙) 2019-03-21 발언 - 웨이백 보존본으로만 확인
더 분명한 것은 그 2011년 글 자체입니다. 글은 지운 적 없이 그대로 있는데, 맨 위에 구글이 직접 붙인 한 줄이 있습니다. 2012년 글에도 같은 줄이 붙어 있습니다.8[8]배너 전문은 이렇게 이어집니다. “Check out our up-to-date guide to pagination.” 구글이 옛 글을 지우지 않고 배너만 붙여 두는 방식은 다른 주제에서도 보입니다. 덕분에 무엇을 약속했다가 거뒀는지를 한자리에서 볼 수 있습니다. 2011년 글에는 그 아래로 당시 권장안이 그대로 남아 있어서, 지금 기준으로 따라 하면 안 되는 내용이 섞여 있습니다. [2]출처[2] Google 검색 센터 블로그 - Pagination with rel="next" and rel="prev" (2011-09-15, 폐기 배너 붙음)[3] Google 검색 센터 블로그 - Video about pagination with rel="next" and rel="prev" (2012-03-13, 폐기 배너 붙음)
rel=prev/next is not an indexing signal anymore.
약속과 철회가 같은 쪽에 놓여 있는 셈입니다. 아직도 이 태그가 페이지를 합쳐 준다고 적은 글을 보신다면, 2011년 문장을 옮긴 것입니다.
빙은 힌트로 쓰되 합치지는 않습니다
그럼 떼어내야 하느냐 하면, 그건 아닙니다. 빙은 2012년에 이 표시로 사이트의 구조와 범위를 강하게 알려 줄 수 있다고 적었습니다.9[9]빙 웹마스터 블로그 2012년 4월 14일 글의 문장입니다. “through the use of the optional rel=“next” and rel=“prev” link elements, you can provide Bing with a strong indication of the structure and scope of the sequenced content on your site.” 같은 글은 이 표시를 넣어도 검색 결과 모양이 달라지지는 않는다고 못 박았습니다. “Implementing these rel=“next” and rel=“prev” link elements doesn’t trigger a new visual treatment for your pages on our search result pages.”출처[9] Bing Webmaster Blog - Implementing Markup For Paginated And Sequenced Content (2012-04-14)
2019년 구글 발표 몇 시간 뒤에 빙 담당자가 남긴 말이 더 정확합니다. 발견과 구조 이해를 위한 힌트로 쓴다면서, 동시에 두 가지를 못 박았습니다. 색인에서 페이지를 합치지 않고, 순위 모형에도 쓰지 않는다는 것입니다. 남겨 두어도 손해는 없지만, 구글이 하던 일을 빙이 대신해 주지는 않는다는 뜻입니다.10[10]당시 빙의 랭킹 담당자였던 Frédéric Dubut의 글입니다. “We’re using these (like most markup) as hints for page discovery and site structure understanding. At this point we’re not merging pages together in the index based on these and we’re not using prev/next in the ranking model.” 계정이 비공개로 바뀌어 보존본으로만 확인했습니다. 한 가지 더 알아 두실 것은, 지금 빙 웹마스터 가이드라인에는 페이지네이션 이야기가 아예 없다는 점입니다. 저희가 전문을 받아 확인했고, 2019년 이후 빙의 공식 언급은 찾지 못했습니다. [10]출처[10] Bing Webmaster Guidelines (현행)[11] Frédéric Dubut(당시 빙) 2019-03-21 발언 - 웨이백 보존본으로만 확인
표준은 이 태그를 다른 용도로 남겼습니다
검색엔진 밖에서는 이 표시가 아직 살아 있습니다. HTML 표준은 rel="next"를 만나면 브라우저가 다음 페이지를 미리 당겨 오는 힌트처럼 처리하라고 적어 두었습니다.11[11]HTML 표준의 문장입니다. “When the next keyword is used with a link element, user agents should process such links as if they were using one of the dns-prefetch, preconnect, or prefetch keywords. Which keyword the user agent wishes to use is implementation-dependent.” 여기서 두 가지를 보셔야 합니다. 하나는 should라는 낱말이고, 다른 하나는 implementation-dependent입니다. 그리고 이 조항은 next에만 있습니다. prev 절에는 같은 문장이 없습니다. 저희는 이 표시를 실제로 그렇게 처리하는 브라우저를 확인하는 문서는 찾지 못했습니다.출처[12] HTML Living Standard - Link types (WHATWG)
다만 표준이 쓴 말은 “그렇게 해야 한다”가 아니라 그렇게 하는 게 좋다이고, 어떤 방식을 쓸지는 브라우저가 정합니다. 그래서 브라우저가 실제로 미리 당겨 온다고 믿고 설계하면 안 됩니다.
진짜 쟁점은 캐노니컬
각 페이지는 자기 주소와 캐노니컬을 가집니다
버린 태그 이야기보다 중요한 것이 여기 있습니다. 구글은 페이지마다 고유한 주소를 주라고 적습니다. ?page=2 같은 파라미터를 쓰면 됩니다. 페이지네이션으로 이어진 주소들을 구글이 서로 다른 페이지로 취급하기 때문입니다.12[12]구글 페이지네이션 문서의 문장입니다. “Give each page a unique URL. For example, include a ?page=n query parameter, as URLs in a paginated sequence are treated as separate pages by Google.” 주소를 나누는 방식 자체는 자유롭습니다. 구글은 같은 쪽에서 example.com/category?name=fun-items&page=1 같은 번호 방식과 example.com/fun-items?lastid=567 같은 이어받기 방식을 둘 다 좋은 예로 들었습니다. 중요한 것은 쪽마다 주소가 따로 있느냐입니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
주소를 # 뒤에 붙여 나누면 안 됩니다. 구글은 # 뒤를 무시하므로, 다음 페이지 주소가 그 부분만 다르면 이미 가져온 쪽이라고 보고 따라가지 않을 수 있습니다.13[13]같은 문서의 문장입니다. “Don’t use URL fragment identifiers (the text after a # in a URL) for page numbers in a collection. Google ignores fragment identifiers. If Googlebot sees a URL to the next page that only differs by the text after the #, it may not follow the link, thinking it has already retrieved the page.” 무한 스크롤을 쓰는 사이트에서 #page=2 꼴을 자주 보게 되는데, 바로 이 경우에 해당합니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
첫 페이지로 몰면 뒤쪽이 사라집니다
가장 자주 보는 실수입니다. 2페이지, 3페이지의 캐노니컬을 전부 1페이지로 적어 두는 것입니다. 구글은 이걸 하지 말라고 명시하고, 각 페이지가 자기 자신을 가리키게 하라고 적습니다.14[14]같은 문서의 다음 문장입니다. “Don’t use the first page of a paginated sequence as the canonical page. Instead, give each page its own canonical URL.” 구글은 한 가지를 더 권하는데, 모든 쪽에서 첫 페이지로 되돌아가는 링크를 넣어 두라는 것입니다. 그러면 목록의 시작점이 어디인지 알리는 힌트가 되고, 캐노니컬로 몰지 않으면서도 첫 페이지를 강조할 수 있습니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
캐노니컬은 구글이 강한 신호로 받는 표시입니다.15[15]구글 캐노니컬 문서는 어떤 표시가 얼마나 센지를 순서대로 적어 두었습니다. “These are, in order of how strongly they can influence canonicalization: Redirects: A strong signal… rel=“canonical” link annotations: A strong signal that the specified URL should become canonical. Sitemap inclusion: A weak signal…” 리다이렉트와 캐노니컬이 강한 신호이고 사이트맵은 약한 신호입니다. 캐노니컬을 잘못 걸어 두고 사이트맵으로 바로잡으려 해도 잘 되지 않는 이유가 여기 있습니다.출처[8] Google 검색 센터 - How to specify a canonical URL (영어 원문) 그래서 2페이지를 1페이지로 몰면 “이 둘은 같은 쪽”이라고 신고하는 셈이 됩니다. 1페이지에 없는 상품과 글이 그대로 묻힙니다.
제목과 설명은 같아도 됩니다
반대로 안 고쳐도 되는 것도 있습니다. 보통 페이지마다 제목을 다르게 쓰라고들 하는데, 페이지네이션은 구글이 예외로 인정한 드문 자리입니다. 시퀀스 안의 모든 쪽에 같은 제목과 설명을 써도 된다고 적혀 있습니다.16[16]구글 페이지네이션 문서의 문장입니다. “Normally, we recommend that you give web pages distinct titles to help differentiate them. However, pages in a paginated sequence don’t need to follow this recommendation. You can use the same titles and descriptions for all pages in the sequence. Google tries to recognize pages in a sequence and index them accordingly.” 구글이 중복 제목을 괜찮다고 적는 자리는 흔하지 않습니다. 시퀀스를 알아보고 그에 맞게 색인하려 한다는 말이 함께 붙어 있기 때문입니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
“2페이지, 3페이지” 같은 말을 억지로 붙일 필요가 없다는 뜻입니다.
변형 주소 막는 법
페이지네이션 자체는 막지 않습니다
2페이지부터 noindex를 걸어 두는 곳이 있습니다. 중복처럼 보여서 그렇게 하는 것인데, 구글은 그럴 필요가 없다고 2012년에 이미 답해 두었습니다.17[17]2012년 구글 블로그가 독자 질문에 답한 대목입니다. “There’s no need to mark page 2 to n of the series with noindex unless you’re sure that you don’t want those pages in the index.” 지금 기준으로도 어긋나지 않습니다. 현행 페이지네이션 문서는 막으라는 대상으로 시퀀스가 아니라 같은 목록의 변형을 듭니다. 참고로 빙은 2012년 글에서 시퀀스 안의 특정 쪽을 <meta name="robots" content="noindex, follow">로 빼는 것은 자유라고 적었습니다. [3]출처[3] Google 검색 센터 블로그 - Video about pagination with rel="next" and rel="prev" (2012-03-13, 폐기 배너 붙음)[9] Bing Webmaster Blog - Implementing Markup For Paginated And Sequenced Content (2012-04-14) 2페이지 뒤의 항목을 찾게 하는 것이 목적인데 색인을 막으면 앞뒤가 맞지 않습니다.
막을 것은 정렬·필터 변형입니다
막아야 할 것은 따로 있습니다. 같은 목록을 가격순, 인기순, 색깔별로 다시 보여 주는 주소들입니다. 내용은 같은데 주소만 수십 개로 불어납니다.
구글은 이 변형을 noindex로 색인에서 빼거나 robots.txt로 크롤링을 줄이라고 적습니다.18[18]구글 페이지네이션 문서의 문장입니다. “To avoid indexing variations of the same list of results, block unwanted URLs from being indexed with the noindex robots meta tag or discourage crawling of particular URL patterns with a robots.txt file.” 두 수단을 나란히 적어 두었고, 어느 쪽을 쓸지는 적지 않았습니다. 그 판단 기준이 다음 문단의 크롤 예산 문서에 있습니다.출처[1] Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역) 그런데 크롤 예산 문서에서는 반대로 들리는 말을 합니다. noindex를 쓰지 말라는 것입니다. 구글이 어차피 요청은 하고 나서 태그를 보고 버리기 때문에 크롤링 시간만 낭비된다는 이유입니다.19[19]구글 크롤 예산 문서의 문장입니다. “Don’t use noindex, as Google will still request, but then drop the page when it sees a noindex meta tag or header in the HTTP response, wasting crawling time.” 같은 문서는 robots.txt의 효과를 이렇게 적습니다. “Blocking URLs with robots.txt prevents Google from crawling them, and significantly decreases the chance the URLs will be processed by other Google systems.” 덧붙여 이 문서는 무한 스크롤 페이지를 크롤을 낭비하는 예로 들며 차단 대상에 올려 두었습니다. 무한 스크롤을 쓰면서 뒤에 페이지네이션을 깔아 두지 않으면, 구글이 보기에 낭비 쪽에 가깝다는 뜻입니다.출처[5] Google 크롤링 - Optimize your crawl budget (영어 원문)
모순이 아니라 목적이 다릅니다. 검색 결과에서 빼는 것이 목적이면 noindex이고, 크롤링 자체를 아끼는 것이 목적이면 robots.txt입니다.
둘을 같이 걸면 noindex가 듣지 않습니다
그렇다고 둘을 함께 걸면 안 됩니다. 구글은 noindex가 들으려면 그 쪽이 robots.txt로 막혀 있지 않아야 한다고 못 박습니다. 크롤러가 들어가지 못하면 그 규칙을 아예 보지 못하기 때문입니다.20[20]구글 noindex 문서의 문장입니다. “For the noindex rule to be effective, the page or resource must not be blocked by a robots.txt file, and it has to be otherwise accessible to the crawler. If the page is blocked by a robots.txt file or the crawler can’t access the page, the crawler will never see the noindex rule.” 이미 색인된 쪽을 빼고 싶을 때 특히 조심해야 합니다. 급한 마음에 robots.txt부터 막으면 그 쪽은 색인에 남은 채로 굳습니다.출처[6] Google 검색 센터 - Block Search indexing with noindex (영어 원문)
막아 놓고 색인에서 빠지기를 기다리면 둘 다 안 됩니다.
offset과 cursor
offset은 건너뛸 개수를 세는 방식입니다
?page=2처럼 쪽 번호로 넘기는 것이 offset 방식입니다. “앞에서 20개를 건너뛰고 그다음 10개를 달라”고 세어서 요청하는 방식입니다. 개발 쪽에서는 이것을 고전적인 offset 기반 페이지네이션이라고 부릅니다.21[21]GraphQL 쪽 공식 문서가 쓰는 이름입니다. “The approach described in the first bullet is classic offset-based pagination.” 같은 문서는 두 방식의 호출 모양도 나란히 보여 줍니다. offset 쪽은 friends(first:2 offset:2)이고 cursor 쪽은 friends(first:2 after:$friendCursor)입니다. 뒤엣것은 숫자가 아니라 마지막으로 본 항목의 표식을 넘깁니다.출처[13] GraphQL 공식 문서 - Pagination
다른 쪽은 cursor 방식입니다. 번호를 세지 않고 마지막으로 본 항목 다음부터 달라고 요청합니다.
offset은 새 글이 들어오면 어긋납니다
1페이지를 본 사이에 새 글이 하나 올라오면, 원래 10번째였던 글이 11번째로 밀립니다. 그래서 2페이지를 열면 1페이지에서 이미 본 글이 또 나옵니다. GraphQL 문서는 이 상황을 두고 이후 페이지의 offset 계산이 모호해진다고 적습니다.22[22]같은 문서의 문장입니다. “if new records are added to the database after the user has made a request for a page of results, then offset calculations for subsequent pages may become ambiguous.” 같은 쪽은 offset 방식이 데이터가 클 때 성능과 보안 면에서도 단점이 있을 수 있다고 덧붙입니다. 그래서 cursor 방식을 “가장 강력하다”고 적는데, 대신 설계가 더 복잡해진다는 점도 같이 적어 두었습니다.출처[13] GraphQL 공식 문서 - Pagination
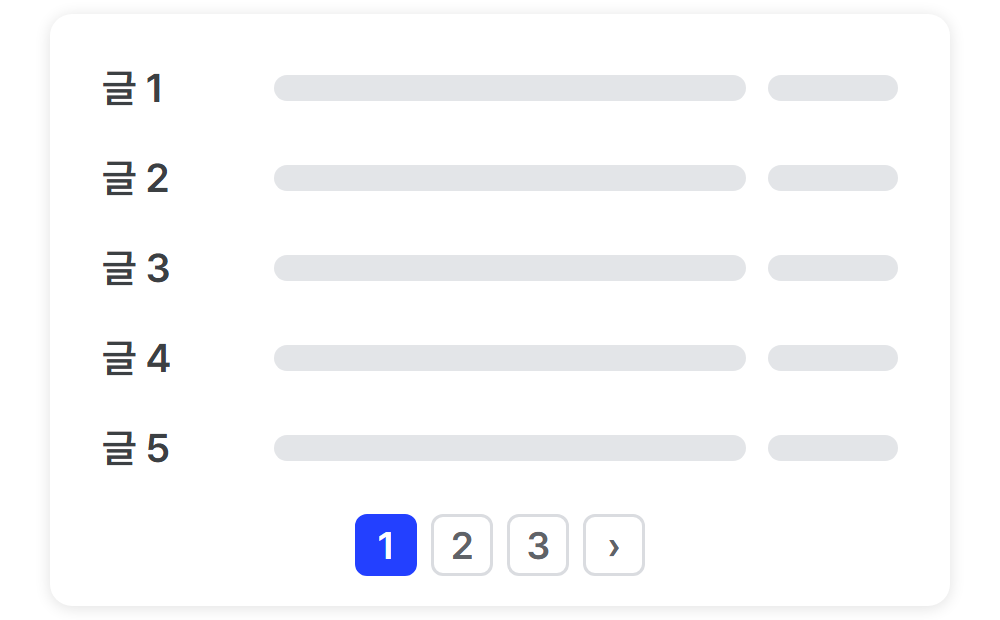
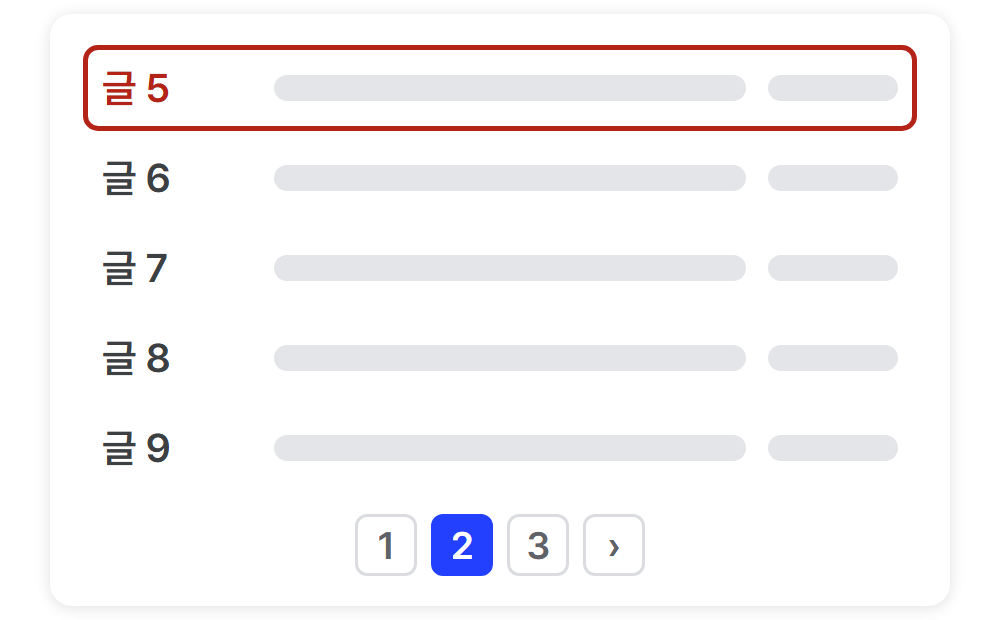
사람에게는 성가신 정도이지만 검색에는 더 큽니다. 구글은 같은 항목이 두 번 나오면 안 된다는 조건을 걸어 두었기 때문입니다.23[23]구글이 내건 조건은 둘입니다. “Coverage: All individual items are accessible.” 와 “No overlap: Each item is listed only once in the paginated series.” 앞의 것은 모든 항목에 닿을 수 있어야 한다는 뜻이고, 뒤의 것이 지금 이야기하는 자리입니다. 쪽이 밀리면서 같은 글이 두 쪽에 걸쳐 나오면 이 조건이 깨집니다.출처[4] Google 검색 센터 블로그 - Infinite scroll search-friendly recommendations (2014-02-13, 낡음 배너 붙음)
그렇다고 offset이 틀린 방식은 아닙니다. 구글은 쪽 번호 방식과 이어받기 방식을 둘 다 좋은 예로 적어 두었습니다.24[24]구글이 든 예는 이렇습니다. “Good: example.com/category?name=fun-items&page=1 / Good: example.com/fun-items?lastid=567 / Less optimal: example.com/fun-items#1” 앞의 것이 번호 방식이고 가운데가 이어받기 방식인데 둘 다 좋음으로 적혀 있습니다. 참고로 구글이 자사 API를 설계할 때 쓰는 지침에서는 커서를 “권장(should)”, 건너뛰기를 “해도 됨(may)“으로 나눠 적습니다. 검색엔진에게는 어느 쪽이든 괜찮지만, 설계 쪽에서는 커서를 위에 둔다는 뜻입니다.출처[4] Google 검색 센터 블로그 - Infinite scroll search-friendly recommendations (2014-02-13, 낡음 배너 붙음) 목록이 자주 바뀌지 않으면 번호 방식이 단순하고, 글이 쉼 없이 올라오는 목록이라면 이어받기 쪽이 안전합니다.
무한 스크롤은 뒤에 주소를 깔아야 합니다
무한 스크롤을 쓰더라도 포기할 것은 없습니다. 구글이 적어 둔 답은 쓰지 말라가 아니라, 무한 스크롤과 나란히 갈 페이지네이션을 만들어 두라는 것입니다.25[25]구글 문서의 문장입니다. “To make sure that search engines can crawl individual items linked from an infinite scroll page, make sure that you or your content management system produces a paginated series (component pages) to go along with your infinite scroll.” 같은 쪽은 조건을 하나 더 답니다. “Chunk your infinite-scroll page content into component pages that can be accessed when JavaScript is disabled.” 자바스크립트가 꺼진 상태에서도 열려야 한다는 뜻입니다.출처[4] Google 검색 센터 블로그 - Infinite scroll search-friendly recommendations (2014-02-13, 낡음 배너 붙음)
자바스크립트를 끈 상태에서도 열리는 주소가 쪽마다 있어야 합니다. 사람은 스크롤로 보고 크롤러는 주소로 보는 셈입니다.
자주 묻는 질문
페이지 네이션이란 무엇인가요?
항목이 많은 목록을 1, 2, 3…으로 나눠 보여 주는 방식입니다. 우리말로는 쪽 나누기나 페이징이라고 합니다. 검색 쪽에서 중요한 것은 모양이 아니라, 2페이지 뒤의 항목까지 검색엔진이 닿을 수 있느냐입니다.
페이지네이션에는 어떤 종류가 있나요?
구글은 셋으로 나눕니다. 번호를 눌러 넘기는 페이지네이션, 버튼을 눌러 더 불러오는 더 보기, 끝까지 내리면 이어지는 무한 스크롤입니다. 뒤의 둘을 쓰더라도 쪽마다 주소가 따로 있어야 합니다.
페이지 네이션 UI는 무엇인가요?
목록 아래에 놓이는 1 2 3 › 같은 쪽 번호 부품을 말합니다. 만들 때 한 가지만 지키시면 됩니다. 번호가 href를 가진 <a> 링크여야 합니다. 버튼이나 onclick으로 만들면 검색엔진이 2페이지를 찾지 못합니다.
offset 방식이란 무엇인가요?
앞에서 몇 개를 건너뛸지 세어서 요청하는 방식입니다. ?page=2가 여기에 해당합니다. 목록에 새 글이 들어오면 항목이 밀려서 같은 글이 두 쪽에 걸쳐 나올 수 있습니다. 글이 쉼 없이 올라오는 목록이라면 마지막으로 본 항목부터 이어받는 cursor 방식이 안전합니다.
더 볼 것
2페이지를 1페이지로 몰면 안 되는 이유는 캐노니컬 태그에서 더 자세히 다룹니다. 목록이 사이트 어느 칸에 들어가는지는 브레드크럼에서, 층을 어떻게 짤지는 홈페이지 구조에서 다룹니다.
출처
- Google 검색 센터 - Pagination and incremental page loading best practices (영어 원문) · 한국어판(기계 번역)
- Google 검색 센터 블로그 - Pagination with rel="next" and rel="prev" (2011-09-15, 폐기 배너 붙음)
- Google 검색 센터 블로그 - Video about pagination with rel="next" and rel="prev" (2012-03-13, 폐기 배너 붙음)
- Google 검색 센터 블로그 - Infinite scroll search-friendly recommendations (2014-02-13, 낡음 배너 붙음)
- Google 크롤링 - Optimize your crawl budget (영어 원문)
- Google 검색 센터 - Block Search indexing with noindex (영어 원문)
- Google 검색 센터 - JavaScript SEO basics (크롤링 가능한 링크, 영어 원문)
- Google 검색 센터 - How to specify a canonical URL (영어 원문)
- Bing Webmaster Blog - Implementing Markup For Paginated And Sequenced Content (2012-04-14)
- Bing Webmaster Guidelines (현행)
- Frédéric Dubut(당시 빙) 2019-03-21 발언 - 웨이백 보존본으로만 확인
- HTML Living Standard - Link types (WHATWG)
- GraphQL 공식 문서 - Pagination